📌 세 줄 요약
- AI 에이전트는 목표를 주면 스스로 단계를 계획하고 도구를 사용해 여러 작업을 이어서 수행하는 AI다.
- 한 번 묻고 한 번 답하는 챗봇과 달리, 계획→실행→점검을 반복하며 일을 끝까지 처리하려 한다.
- 편리하지만 오작동·잘못된 판단 가능성이 있어, 특히 되돌리기 어려운 작업에서는 사람의 검증과 권한 통제가 중요하다.
2026년 AI 분야에서 자주 언급되는 키워드 가운데 하나가 “에이전트(agent)” 또는 “에이전틱(agentic) AI”입니다. 그런데 정확히 무엇이 기존 챗봇과 다른지, 왜 화제인지 헷갈리는 분이 많습니다. 한마디로 에이전트는 “답만 주는 AI”가 아니라 “일을 대신 해내려는 AI”입니다. 이 글에서는 개념과 작동 방식, 활용 사례, 그리고 아직 조심해야 하는 이유를 쉽게 풀어 봅니다.
ℹ️ 참고 — 특정 제품보다 작동 방식과 판단 기준 중심으로 설명합니다. 아래의 판단 기준은 도구가 바뀌어도 대체로 유효합니다. 다만 권한 설정 방식과 승인 절차는 도구마다 다르므로 각 도구의 설정 화면에서 확인하세요.
AI 에이전트란 무엇인가 — 뜻과 정의
AI 에이전트의 뜻은 사용자가 준 목표를 달성하기 위해 스스로 필요한 단계를 세우고, 외부 도구를 사용하며, 중간 결과를 보고 다음 행동을 정하는 AI 시스템을 가리킵니다. 핵심은 세 가지입니다.
- 목표 설정과 계획: “이걸 해 줘”라는 요청을 잘게 나눠 실행 순서를 짬
- 도구 사용: 검색, 파일 읽기·쓰기, 프로그램 실행, 외부 서비스 연결 등을 활용
- 반복과 자기 점검: 도구 실행 결과나 오류 메시지 같은 외부 신호를 받아 부족한 점을 고쳐 재시도
즉, 사람이 매 단계를 일일이 지시하지 않아도 어느 정도 알아서 진행한다는 점이 특징입니다.
기존 챗봇과 무엇이 다른가
가장 큰 차이는 “자율성의 범위”입니다. 차이는 도구가 있느냐가 아니라, 사람이 매번 시키느냐 아니면 목표만 주면 스스로 이어서 진행하느냐입니다. 챗봇은 한 번의 응답 범위에서 끝나지만, 에이전트는 목표를 채울 때까지 여러 단계에 걸쳐 도구를 반복해서 씁니다.
요즘 챗봇 상당수도 웹 검색·파일 읽기 정도는 지원합니다. 무료 요금제에는 파일 업로드 횟수 같은 한도가 붙는 경우가 많지만, 한도의 유무와 형태는 서비스마다 다르고 수시로 바뀌므로 각 서비스의 최신 공지를 확인하세요.
표: 일반 챗봇과 AI 에이전트 비교
| 구분 | 일반 챗봇 | AI 에이전트 |
|---|---|---|
| 방식 | 한 번의 응답 안에서 완결 | 목표를 채울 때까지 계획 → 실행 → 점검 반복 |
| 도구 사용 | 검색·파일 등 일부 사용(요금제·도구에 따라 다름), 대개 한 번의 응답 안에서만 | 목표 달성까지 여러 단계에 걸쳐 스스로 도구를 골라 반복 사용 |
| 작업 범위 | 정보 제공·초안 | 여러 단계를 이어 실제 처리 |
| 자율성 | 낮음 | 상대적으로 높음 |
| 사람 개입 | 매 요청마다 | 목표 제시 → 중간 점검 → 결과물 검증(필수) |
예를 들어 “다음 주 회의 일정을 잡아 줘”라고 하면, 챗봇은 방법을 설명해 주지만 에이전트는 참석자 일정을 확인하고 빈 시간을 찾아 초대장을 만드는 것까지 시도합니다. 물론 연결된 권한 범위 안에서만 가능합니다.
AI 에이전트 작동 방식: 계획 → 실행 → 점검 루프
에이전트는 대체로 다음 흐름을 돌립니다.
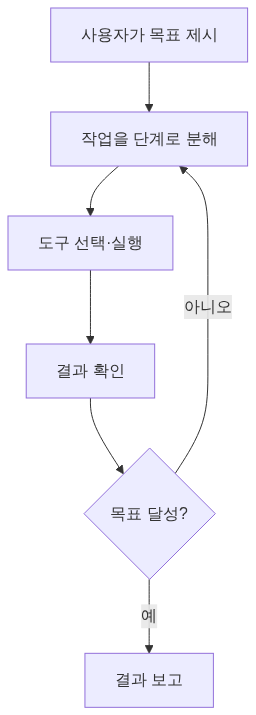
그림: AI 에이전트의 자율 루프 — 목표 설정 → 계획 수립 → 도구 실행 → 관찰·평가(점검), 목표를 채우면 완료. “목표를 달성했는가”라는 판단은 대개 사람이 아니라 모델 자신이 내립니다 (개념 도식, 제품별 구현은 다름 · 자체 제작)
이 루프를 돌다가 목표를 채웠다고 판단하면 멈춥니다. 덕분에 여러 단계가 필요한 일을 한 번의 요청으로 처리할 수 있고, 반대로 중간 판단이 틀리면 그 오류가 다음 단계로 그대로 넘어갑니다.
안을 조금 더 들여다보면 — LLM + 도구 + 메모리
에이전트를 뜯어보면 대개 네 가지 부품이 조합돼 있습니다. 실무 설명·연구 문헌에서 반복해서 등장하는 구성입니다.
| 부품 | 역할 | 비유 |
|---|---|---|
| LLM(대형언어모델) | 상황을 읽고 다음에 뭘 할지 결정하는 두뇌 | 판단하는 사람 |
| 도구(tools) | 검색·코드 실행·파일 읽기·외부 API 호출 등 실제 행동 수단 | 손과 도구상자 |
| 메모리(memory) | 진행 중인 단계를 기억하는 단기기억 + 과거 대화·결과를 남기는 장기기억 | 메모장·수첩 |
| 계획(planning) | 목표를 하위 단계로 쪼개고 순서를 정하는 절차 | 할 일 목록 |
2026년 현재 가장 널리 쓰이는 진행 방식은 ReAct(Reason + Act, 추론과 행동을 번갈아) 패턴입니다. 매 단계에서 “지금 아는 것을 근거로 무엇을 할지 생각(reason) → 도구를 실행(act) → 결과를 관찰(observe)”을 반복하는 구조로, 에이전트가 왜 그 행동을 했는지가 사고 과정으로 남아 추적·디버깅이 쉬워진다는 점 때문에 표준처럼 자리 잡았습니다.
ℹ️ 참고 — “LLM에 도구·메모리·계획을 덧붙인 구조”라는 이 뼈대는 제품이 바뀌어도 대체로 유지됩니다. 겉으로 보이는 이름(코딩 에이전트·리서치 에이전트·컴퓨터 사용 에이전트)이 달라도 안쪽 원리는 비슷합니다.
AI 에이전트 활용 사례
에이전트가 특히 쓸모 있는 분야입니다.
- 일정·업무 조율: 회의 시간 조정, 할 일 정리, 알림 설정 (캘린더·메일은 필요한 범위만 연결하고, 초대장 발송·외부 전송은 사람이 확인)
- 리서치: 여러 자료를 검색·비교해 요약 보고서 초안 작성 (요약은 원문과 대조한 뒤 사용하고, 인용 범위·출처 표기 확인)
- 코딩 보조: 요구사항을 받아 코드 작성·실행·오류 수정 반복 (실행은 격리된 작업 폴더·테스트 계정에서, 결과 코드는 병합 전 사람이 검토)
- 반복 업무 자동화: 정해진 절차의 데이터 수집·정리·양식 채우기 (수집 대상 사이트의 이용약관·수집 허용 범위 확인)
- 고객 응대 보조: 문의를 분류하고 관련 정보를 찾아 답변 초안 제시 (고객 정보를 외부 도구에 넘기는 일이므로 개인정보 처리 위탁 절차와 사내 승인을 먼저 확인)
도구별 검색 품질 차이는 무료 AI 챗봇 고르는 법 2026, 코딩 쪽 구체적인 도구·워크플로는 개발자 AI 활용법, 목표를 어떻게 적어 주느냐에 따라 결과가 달라지는 문제는 ChatGPT 프롬프트 잘 쓰는 법에서 정리했습니다.
💡 팁 — 처음에는 되돌리기 쉬운 일(자료 정리, 초안 작성)부터 맡겨 보세요. 다만 되돌리기 쉽다는 것과 검증이 필요 없다는 것은 다릅니다. 요약·초안은 사실이 아닌 내용이 섞이기 쉬우므로 그대로 쓰지 말고 원문과 대조하세요.
한계와 주의점
에이전트는 강력하지만 아직 완성된 기술이 아닙니다.
⚠️ 주의 — 되돌리기 어려운 작업 — 에이전트가 스스로 판단한 결과가 항상 옳지는 않습니다. 잘못된 정보를 사실처럼 만들거나, 의도와 다른 행동을 할 수 있습니다. 결제·파일 삭제·외부 발송·코드나 명령 자동 실행처럼 되돌리기 힘든 작업에는 반드시 사람의 확인 단계를 두세요.
⚠️ 주의 — 회사 자원을 연결하기 전에 — 회사 메일·캘린더·문서를 에이전트에 연결하는 것은 사내 보안규정 위반이 될 수 있습니다. 개인정보가 포함된 자료를 해외 사업자 서비스에 넘기는 경우에는 개인정보 보호법상 국외 이전 요건(정보주체의 별도 동의, 또는 계약 이행에 필요한 처리위탁·보관으로서 처리방침에 공개한 경우 등 법정 근거)도 따져야 합니다. 사내에 명시적 규정이 없더라도, 미공개 사업자료·고객사에서 받은 자료·비밀유지 계약 대상 문서는 개인 판단으로 넣지 마세요. 규정 부재가 허용을 뜻하지는 않습니다. 연결하기 전에 소속 조직의 승인 범위를 먼저 확인하세요.
주요 한계
- 오작동·환각: 근거 없는 내용을 사실처럼 처리할 수 있음
- 오류 누적: 초반 판단 실수가 뒤 단계까지 번짐. 외부 근거 없이 자기 답이 맞는지 스스로 판단하는 능력은 상대적으로 약해(2023년 연구에서 지적된 한계), 틀린 답을 옳다고 확신한 채 다음 단계로 넘어가는 경우가 여전히 보고됨
- 권한 위험: 넓은 권한을 주면 의도치 않은 작업을 실행할 수 있음
- 보안: 민감 정보 접근·외부 연결 시 유출 위험
- 프롬프트 인젝션(외부 콘텐츠에 의한 조작): 에이전트가 읽는 웹페이지·문서·메일에 숨겨진 명령문이 들어 있으면, 에이전트가 그것을 사용자 지시로 착각하고 따를 수 있음. 사용자가 시키지 않은 행동(데이터 외부 전송 등)으로 이어질 수 있음. OWASP는 2026년판 LLM Top 10에서도 프롬프트 인젝션을 1순위로 유지했고, 도구 사용 권한 남용(Excessive Agency)은 2025년판 6위에서 2026년판 3위로 올랐음. 에이전트 전반의 위험은 별도의 Agentic Top 10에서 더 자세히 다룸
- 비용: 목표를 채울 때까지 반복 호출하므로 한 번의 지시가 예상보다 큰 사용량·요금으로 이어질 수 있음 — 사용량 한도·예산 알림을 먼저 설정
- 저작권·라이선스: 에이전트가 수집한 자료를 그대로 옮기면 무단 전재가 될 수 있고, 생성된 코드에 라이선스 제약이 있는 코드가 섞일 수 있음
안전 체크리스트
- ☐ 에이전트에게 필요한 최소한의 권한만 부여했는가
- ☐ 되돌리기 어려운 작업에 사람 승인 단계를 넣었는가
- ☐ 결과물을 쓰기 전에 사실관계를 원문과 대조해 확인하는가
- ☐ 외부로 나가거나 다른 판단의 근거가 되는 결과는 발송 전에 한 번 더 검증하는가
- ☐ 민감 정보 접근 범위를 제한했는가
- ☐ 넣으려는 자료가 비밀유지 의무나 계약 제한에 걸리지 않는지 확인했는가
- ☐ 사용량·비용 상한과 예산 알림을 설정했는가
- ☐ 에이전트가 외부에서 가져온 내용을 “지시”가 아니라 “자료”로만 다루도록 구분했는가
- ☐ 신뢰할 수 없는 외부 자료를 읽는 에이전트에 전송·결제 권한을 주지 않았는가
- ☐ 결과물에 출처 표기·인용 범위와 코드 라이선스를 확인했는가
- ☐ 에이전트가 어떤 도구를 언제 실행했는지 기록을 확인할 수 있는가
- ☐ 쓰지 않게 된 연동과 발급한 접근 권한을 주기적으로 해제하는가
2026년, 실제로 어디까지 쓰이나 — 코딩·컴퓨터 사용
가장 먼저, 그리고 가장 눈에 띄게 자리 잡은 분야는 코딩입니다. JetBrains가 2026년 5~7월 개발자를 조사한 결과, 전문 개발자의 약 90%가 최소 주 1회 이상 AI 코딩 에이전트를 업무에 쓴다고 답했습니다. 도구 점유율은 계속 뒤바뀌는 중이라 특정 제품 순위는 참고만 하는 편이 좋습니다.
또 하나 커진 갈래는 “컴퓨터·브라우저를 직접 조작하는” 에이전트입니다. 화면을 읽고 마우스·키보드를 흉내 내 사람처럼 웹을 다루는 방식으로, 앤트로픽의 Computer Use(2024년 10월 공개), 구글 Project Mariner, OpenAI의 컴퓨터 사용 에이전트, 아마존 Nova Act 등 주요 사업자가 모두 자체 방식을 내놓았습니다.
표: 2026년 에이전트가 실제로 쓰이는 대표 갈래
| 갈래 | 하는 일 | 성숙도(대략) |
|---|---|---|
| 코딩 보조 | 요구사항→코드 작성·실행·오류 수정 반복 | 실무 정착(개발자 다수 상시 사용) |
| 컴퓨터·브라우저 사용 | 화면을 보고 웹·앱을 사람처럼 조작 | 확산 중, 신뢰성·속도는 아직 과제 |
| 리서치·요약 | 여러 자료 검색·비교→보고서 초안 | 초안용으로 유용, 사실 대조 필수 |
| 고객 응대 보조 | 문의 분류·정보 검색·답변 초안 | 도입 활발, 민감정보 처리 주의 |
⚠️ 주의 — “정착”이 “무결”은 아니다 — 널리 쓰인다는 것과 항상 정확하다는 것은 다릅니다. 코딩 에이전트조차 잘못된 코드나 존재하지 않는 함수를 자신 있게 만들어 내는 경우가 있어, 병합 전 사람 검토는 여전히 표준 절차입니다.
2026년 현재 어디까지 왔나
전망으로만 미루기는 어려운, 이미 움직이기 시작한 변화들이 있습니다.
- 도구 연결 방식이 특정 회사 소유를 벗어나기 시작했습니다. Anthropic이 공개한 MCP(Model Context Protocol)가 2025년 12월 리눅스 재단 산하 Agentic AI Foundation으로 이관됐고, OpenAI·구글·마이크로소프트·AWS 등이 참여합니다. 다만 도구 연결·협업 방식이 MCP 하나로 통일된 상태는 아니며, 여러 방식이 병존합니다.
- 여러 에이전트가 역할을 나눠 협업하는 구조도 개발 도구와 기업 시스템에서 시도되고 있습니다. 여기서 연결 규약은 대략 두 갈래로 정리되는 흐름입니다 — MCP는 에이전트가 “바깥 도구·데이터에 접근”하는 방식을, A2A(Agent-to-Agent)는 에이전트끼리 “서로 협업”하는 방식을 다룹니다. 실제 시스템에서는 둘을 함께 쓰는 구성이 흔합니다. 다만 에이전트를 여러 개 붙일수록 오류 추적과 비용 관리가 어려워진다는 지적이 많고(메모리·맥락이 에이전트마다 어긋나는 문제 등), Gartner는 비용 급증·불분명한 사업가치·미흡한 리스크 통제로 중단되는 에이전틱 AI 프로젝트가 늘 것으로 전망합니다(2025-06).
남은 과제는 기술보다 운영 쪽에 있습니다. 연결 방식이 자리를 잡아도 권한 관리·검증 절차·비용 통제는 도입하는 쪽이 직접 설계해야 하고, 자율성이 높아질수록 그 부담도 함께 커집니다.
자주 묻는 질문(FAQ)
AI 에이전트와 챗봇은 완전히 다른 건가요?
기반 기술은 겹치지만, 챗봇은 한 번의 응답으로 끝나고 에이전트는 목표를 채울 때까지 여러 단계를 스스로 이어서 실행합니다. 항목별 차이는 위 “기존 챗봇과 무엇이 다른가” 절의 비교표를 참고하세요.
AI 에이전트가 알아서 다 해 주나요?
아닙니다. 스스로 진행하는 부분이 많아졌을 뿐, 판단이 틀릴 수 있어 사람의 점검이 여전히 필요합니다.
개인도 AI 에이전트를 쓸 수 있나요?
네. 일정 정리, 자료 조사, 코딩 보조 같은 형태로 이미 개인용 도구가 제공됩니다. 기능·요금은 도구마다 다르고 변동 가능합니다. 다만 캘린더·메일 같은 개인 계정을 연결할 때는 필요한 범위만 허용하고, 회사 계정은 사내 규정을 확인하기 전에 연결하지 마세요. 입력한 내용의 저장·학습 여부는 도구마다 다르니 개인정보 처리방침을 확인하세요.
어떤 일에는 에이전트를 쓰면 안 되나요?
위 “되돌리기 어려운 작업” 주의 박스에 적은 일들이 그렇습니다. 이런 작업은 권한을 통째로 넘기는 대신, 에이전트가 초안까지만 만들고 실행 버튼은 사람이 누르는 구조로 나누는 편이 안전합니다.
에이전트는 대체 어떻게 “스스로” 판단하나요?
대부분 ReAct(추론과 행동을 번갈아 하는) 방식으로 움직입니다. “지금 아는 것으로 다음에 뭘 할지 생각 → 도구 실행 → 결과 관찰”을 반복하고, 그 결과를 보고 다음 행동을 정합니다. 사람이 매 단계를 지시하지 않는다는 뜻이지, 목표나 정답을 스스로 만들어 낸다는 뜻은 아닙니다. 자세한 구조는 위 “안을 조금 더 들여다보면” 절을 참고하세요.
MCP가 뭔가요? 꼭 알아야 하나요?
MCP(Model Context Protocol)는 에이전트가 외부 도구·데이터에 접근하는 방식을 표준화하려는 규약입니다. 일반 사용자가 이름까지 알 필요는 없지만, “에이전트가 여러 서비스에 어떻게 연결되는가”를 정하는 밑바탕이라 최근 자주 언급됩니다. 2025년 12월 리눅스 재단 산하 재단으로 이관돼 특정 회사 소유를 벗어나기 시작했습니다.
마무리
AI 에이전트는 “묻고 답하는 AI”에서 “일을 대신 해내려는 AI”로의 변화를 뜻합니다. 계획하고 도구를 쓰고 실행 결과를 보며 고쳐 나가는 방식 덕분에 리서치·일정·코딩·반복업무에서 도움이 될 수 있습니다. 다만 절차가 명확한 작업일수록 잘 되고, 판단이 많이 필요한 작업일수록 결과가 흔들립니다. 최소 권한과 사람의 검증이라는 안전장치를 잊지 마세요.
출처
- Anthropic, “Donating the Model Context Protocol and establishing the Agentic AI Foundation” — https://www.anthropic.com/news/donating-the-model-context-protocol-and-establishing-of-the-agentic-ai-foundation (2026-08 확인)
- Linux Foundation, “Linux Foundation Announces the Formation of the Agentic AI Foundation” — https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation (2026-08 확인)
- OWASP GenAI Security Project, “OWASP GenAI LLM Top 10 2026” — https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/ (2026-08 확인)
- OWASP GenAI Security Project, “OWASP Top 10 for Agentic Applications 2026” — https://genai.owasp.org/resource/owasp-top-10-for-agentic-applications-for-2026/ (2026-08 확인)
- 국가법령정보센터, 개인정보 보호법 제28조의8(개인정보의 국외 이전) — https://www.law.go.kr/%EB%B2%95%EB%A0%B9/%EA%B0%9C%EC%9D%B8%EC%A0%95%EB%B3%B4%20%EB%B3%B4%ED%98%B8%EB%B2%95/%EC%A0%9C28%EC%A1%B0%EC%9D%988 (2026-08 확인)
- Gartner, “Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027” 보도자료(2025-06-25) — https://www.gartner.com/en/newsroom/press-releases/2025-06-25-gartner-predicts-over-40-percent-of-agentic-ai-projects-will-be-canceled-by-end-of-2027 (원문 페이지가 자동 조회를 차단해 제목·수치는 2차 출처 기준, 발행 전 링크 유효성 확인 필요)
- OpenAI Help Center, “ChatGPT Free tier FAQ” — https://help.openai.com/en/articles/9275245-chatgpt-free-tier-faq (2026-08 확인, 기능·정책은 변동 가능)
- OpenAI Help Center, “ChatGPT Search” — https://help.openai.com/en/articles/9237897-chatgpt-search (2026-08 확인)
- Huang et al., “Large Language Models Cannot Self-Correct Reasoning Yet” — https://arxiv.org/abs/2310.01798 (2026-08 확인)
- Yao et al., “ReAct: Synergizing Reasoning and Acting in Language Models” — https://arxiv.org/abs/2210.03629 (2026-08 확인, ReAct 패턴 원논문)
- JetBrains Blog, “AI Coding Agents: Adoption Trends (2026)” — https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/ (2026-08 확인, 개발자 주 1회 이상 사용 ~90% 수치)
- “The Orchestration of Multi-Agent Systems: Architectures, Protocols, and Enterprise Adoption” — https://arxiv.org/abs/2601.13671 (2026-08 확인, MCP=도구 접근·A2A=에이전트 협업 구분)
- The Next Web, “Google Cloud Next 2026: AI agents, A2A protocol” — https://thenextweb.com/news/google-cloud-next-ai-agents-agentic-era (2026-08 확인, 컴퓨터 사용·A2A 동향)
이 글은 일반적인 정보 제공을 목적으로 하며 특정 제품 추천이나 투자·기술 도입 자문이 아닙니다. 실제 도입 시에는 조직의 보안·권한 정책을 함께 검토하시기 바랍니다.